Sử dụng phần mềm Stata trong kinh tế lượng
Đặng Văn Chương
11 tháng 7, 2026
Kinh tế lượng hiện đại phụ thuộc vào công cụ phân tích số liệu mạnh mẽ để kiểm định giả thuyết và ước lượng mô hình. Stata nổi lên như một trong những phần mềm phổ biến nhất trong cộng đồng nghiên cứu kinh tế nhờ khả năng xử lý dữ liệu lớn, cú pháp lệnh linh hoạt và thư viện package phong phú. Sinh viên kinh tế, nghiên cứu sinh và chuyên gia phân tích tại các trường đại học ở Việt Nam ngày càng sử dụng Stata cho luận văn và bài nghiên cứu.
Tổng quan về phần mềm Stata
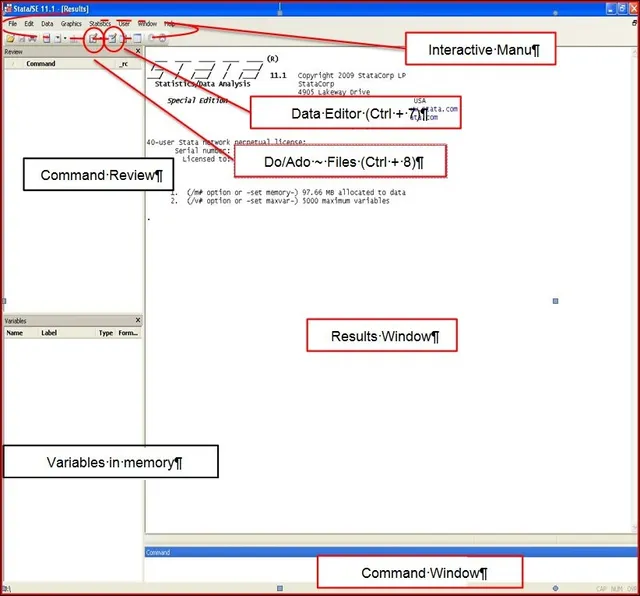
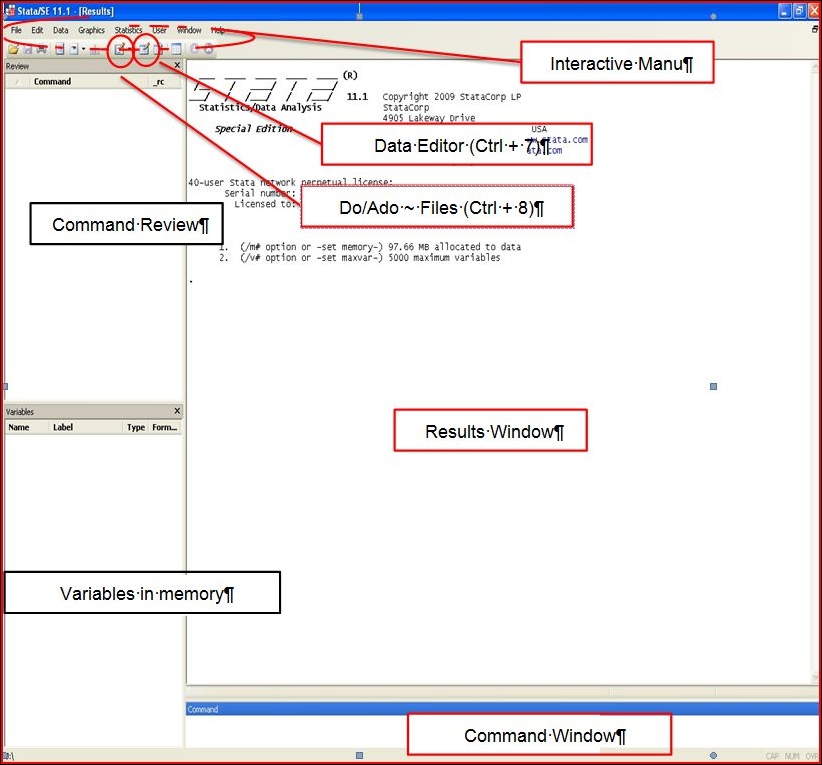
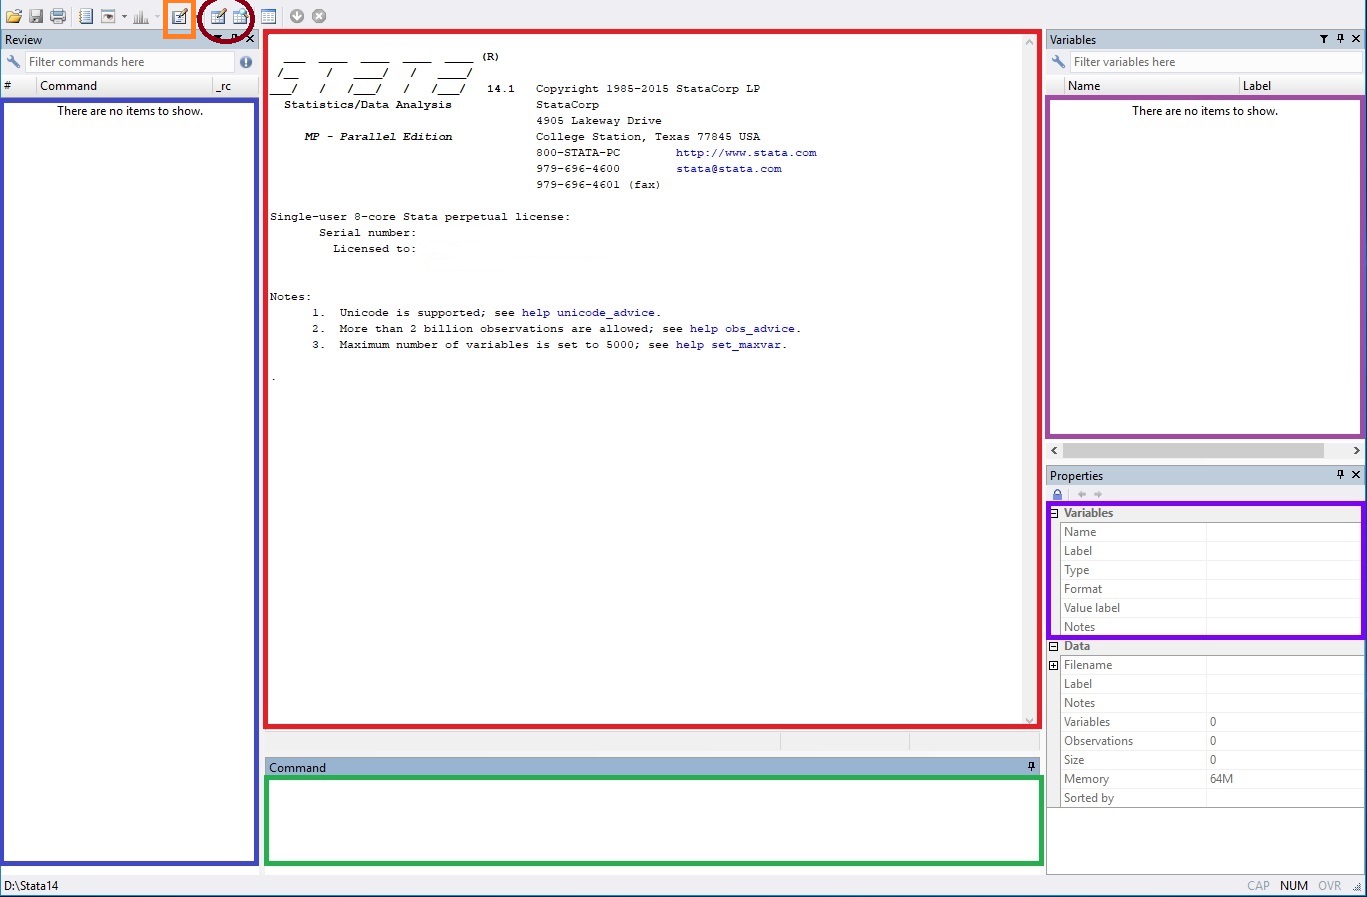
Stata là phần mềm thống kê tích hợp các chức năng quản lý dữ liệu, phân tích đồ họa, mô hình hóa và lập trình. Phần mềm phát triển từ năm 1985 và hiện có nhiều phiên bản từ Stata/SE (Standard Edition) cho dữ liệu kích thước trung bình đến Stata/MP (Multi-processor) cho xử lý dữ liệu lớn song song. Giao diện Stata bao gồm 4 cửa sổ chính: Command window (nhập lệnh), Results window (hiển thị kết quả), Variables window (danh sách biến) và Review window (lịch sử lệnh đã thực hiện).
Cơ chế xử lý dữ liệu của Stata dựa trên kiến trúc in-memory: toàn bộ dataset được nạp vào RAM thay vì đọc-ghi liên tục từ ổ cứng. Điều này cho phép thực hiện các phép biến đổi và tính toán nhanh chóng trên dataset vài triệu dòng. Stata lưu dữ liệu dưới dạng binary (.dta) với metadata về label, format, và value labels đi kèm — khác với file text thuần túy, giúp bảo toàn cấu trúc dữ liệu khi chuyển giữa các phiên bản. Khi dataset vượt quá dung lượng RAM, Stata/MP sử dụng kỹ thuật chunking để chia nhỏ dữ liệu, xử lý song song trên đa lõi CPU rồi tổng hợp kết quả, duy trì hiệu suất mà không yêu cầu người dùng điều chỉnh quy trình làm việc.
Ưu điểm lớn nhất của Stata trong kinh tế lượng là hệ thống lệnh nhất quán và tài liệu hướng dẫn chi tiết. Lệnh regress cho hồi quy OLS cơ bản, ivregress cho mô hình biến công cụ, xtreg cho dữ liệu panel, streg cho phân tích sống còn — tất cả tuân theo cùng cấu trúc command varlist, options. Điều này giúp người dùng chuyển đổi giữa các phương pháp ước lượng mà không phải học lại cú pháp từ đầu. Ngoài ra, kho user-written package tại SSC (Statistical Software Components) chứa hàng nghìn lệnh bổ sung do cộng đồng đóng góp, mở rộng khả năng phân tích lên các phương pháp mới như Difference-in-Differences với robust standard error hay Synthetic Control.
Thiết lập môi trường làm việc Stata
Cài đặt Stata khá đơn giản: tải file installer từ website chính thức, chọn phiên bản phù hợp (Stata/BE, Stata/SE, hoặc Stata/MP) và kích hoạt license. Sau khi cài, bước quan trọng là cấu hình working directory và user profile. Lệnh cd "path/to/folder" đặt thư mục làm việc mặc định, giúp mọi file input/output được lưu trữ có tổ chức. Tệp profile.do (hoặc stata17.do tùy phiên bản) trong thư mục user sẽ tự động chạy mỗi khi mở Stata — nơi cài đặt các preference như set more off (tự động cuộn kết quả dài), set matsize 1000 (tăng kích thước ma trận), hoặc định nghĩa macros dùng chung.
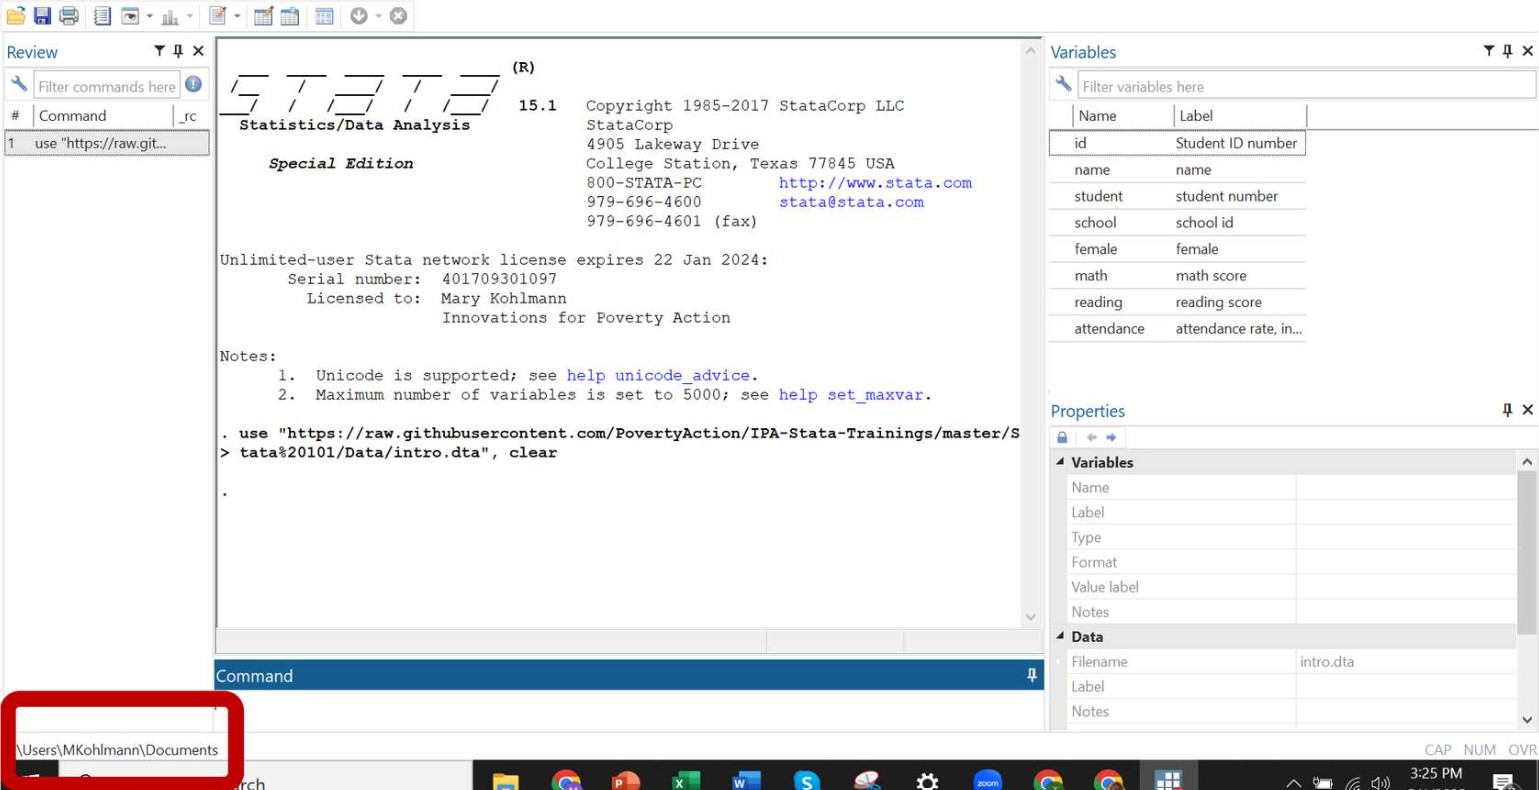
Cơ chế tổ chức dữ liệu trong Stata theo mô hình sheet-like: mỗi biến là một cột, mỗi quan sát là một dòng, tương tự Excel nhưng có tính năng kiểm tra kiểu dữ liệu chặt chẽ hơn. Biến trong Stata có 3 thuộc tính chính: name (tên biến, tối đa 32 ký tự, không bắt đầu bằng số), type (kiểu dữ liệu: byte, int, long, float, double, str cho string), và label (mô tả biến). Khi nhập dữ liệu từ CSV, Excel, hay file text, Stata tự động phát hiện kiểu dữ liệu nhưng vẫn cần người dùng kiểm tra bằng lệnh describe. Đặc biệt, biến string không thể dùng trong tính toán toán học — cần chuyển sang numeric bằng destring hoặc encode thành factor. Hệ thống value labels (gán nhãn cho các giá trị số) cho phép hiển thị "Nam/Nữ" thay vì "0/1" trong output nhưng vẫn lưu trữ dạng numeric để tính toán, giải quyết mâu thuẫn giữa độ thân thiện hiển thị và hiệu năng xử lý.
Quản lý thư mục và file hiệu quả giúp tránh lỗi đường dẫn khi làm việc trên nhiều máy. Thực hành tốt là tạo cấu trúc thư mục rõ ràng: data/ cho file gốc, output/ cho kết quả xuất ra, do/ cho file lệnh, và log/ cho file log. Lệnh log using "filename.log", replace ghi toàn bộ kết quả session vào file text, giúp tái tạo lại quy trình phân tích sau này. Trong nghiên cứu kinh tế lượng, tính reproducibility (có thể tái tạo kết quả) cực kỳ quan trọng — reviewer của tạp chí thường yêu cầu file do-file và data để verify. Đội ngũ biên tập Kho Tàng Kiến Thức VN nhận thấy nhiều nghiên cứu sinh gặp khó khăn khi không tổ chức do-file khoa học, dẫn đến khó khăn khi editor yêu cầu bổ sung robustness check với phương pháp khác.
Xử lý và làm sạch dữ liệu với Stata
Nhập dữ liệu vào Stata có nhiều cách: từ file có sẵn (use "data.dta", import excel "data.xlsx"), nhập thủ công qua Data Editor, hoặc kết nối database qua ODBC. Lệnh import delimited đọc file CSV với khả năng tự động phát hiện delimiter (dấu phẩy, tab, semicolon). Sau khi nhập, lệnh browse mở Data Editor ở chế độ xem chỉ đọc, còn edit cho phép sửa trực tiếp — tuy nhiên cách tốt nhất là làm sạch dữ liệu qua do-file để giữ lại lịch sử biến đổi và khả năng tái hiện. Lưu file Stata bằng save "data_clean.dta", replace để tạo snapshot data đã qua xử lý.
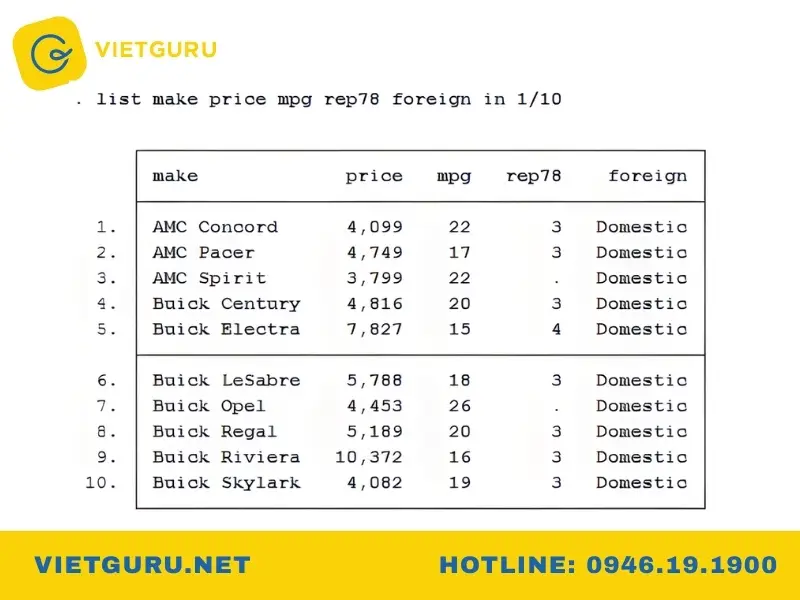
Cơ chế biến đổi và tổng hợp dữ liệu trong Stata dựa trên cú pháp generate/replace và egen. Lệnh generate tạo biến mới từ biểu thức toán học logic: generate log_gdp = log(gdp) hoặc generate treatment = (year >= 2010). Lệnh replace sửa giá trị biến có sẵn: replace income = . if income < 0 (đặt missing value cho thu nhập âm). Để xử lý missing value, Stata dùng ký tự . cho numeric và "" cho string — quan trọng là các phép tính với missing value sẽ trả về missing, do đó cần dùng if !missing(var) để lọc hoặc mi impute để điền missing value bằng phương pháp multiple imputation. Lệnh egen (extended generate) mạnh mẽ hơn: egen mean_income = mean(income), by(region) tính thu nhập trung bình theo nhóm, egen rank = rank(income) xếp hạng, egen max_date = max(date), by(id) lấy ngày cuối cùng cho mỗi cá nhân. Cơ chế behind-the-scenes của egen là tách dataset theo nhóm, áp dụng hàm tổng hợp (sum, mean, max, sd, pctile), rồi merge kết quả ngược lại dataset gốc — tương đương với SQL window function nhưng cú pháp trực quan hơn cho người không chuyên về database.
Kiểm tra chất lượng dữ liệu là bước không thể bỏ qua trước khi ước lượng mô hình. Lệnh summarize hiển thị thống kê mô tả (mean, sd, min, max) để phát hiện outlier: thu nhập trung bình 10 triệu nhưng max là 10 tỷ có thể là lỗi nhập liệu. Lệnh tabulate tạo bảng tần suất cho biến phân loại, phát hiện giá trị bất thường như "99" cho giới tính (nếu code 0/1/2). Lệnh codebook hiển thị chi tiết hơn: kiểu dữ liệu, giá trị duy nhất, missing rate. Để kiểm tra đa cộng tuyến (multicollinearity), sau hồi quy dùng vif (variance inflation factor) — VIF > 10 cảnh báo biến có vấn đề. Khi làm sạch data panel (dữ liệu bảng theo thời gian), cần kiểm tra bằng xtset id year rồi dùng xtdescribe để xác định cấu trúc panel (balanced vs unbalanced) và xtsum để xem biến thiên between (giữa các đơn vị) và within (theo thời gian). Trong nghiên cứu kinh tế lượng Việt Nam, dữ liệu thường unbalanced (một số tỉnh thiếu năm) và có outlier do thống kê không đầy đủ — việc xử lý đúng cách ảnh hưởng trực tiếp đến kết quả ước lượng.
Ước lượng mô hình kinh tế lượng cơ bản
Hồi quy tuyến tính OLS (Ordinary Least Squares) là phương pháp khởi điểm cho hầu hết phân tích kinh tế lượng. Lệnh regress y x1 x2 x3, robust ước lượng mô hình $y = \beta_0 + \beta_1x_1 + \beta_2x_2 + \beta_3x_3 + \varepsilon$ với standard error robust (kiểm soát heteroskedasticity). Kết quả hiển thị gồm coefficient (số ước lượng), t-statistic (kiểm định ý nghĩa thống kê), p-value, và R-squared (độ giải thích của mô hình). Lệnh predict yhat, xb dự báo giá trị y từ mô hình, predict residual, residuals tính phần dư để kiểm tra giả định OLS. Để kiểm tra heteroskedasticity, dùng estat hettest (Breusch-Pagan test) hoặc estat imtest (White test) — p-value < 0.05 bác bỏ giả định phương sai đồng nhất, cần dùng robust SE hoặc GLS.
Cơ chế giải quyết nội sinh (endogeneity) là điểm phân biệt giữa kinh tế lượng cơ bản và nâng cao. Biến nội sinh xảy ra khi có omitted variable bias, measurement error, hoặc reverse causality — dẫn đến ước lượng OLS không nhất quán (inconsistent). Phương pháp biến công cụ (Instrumental Variable - IV) sử dụng biến Z thỏa mãn 2 điều kiện: (1) correlated với biến nội sinh X (relevance condition), (2) không correlated với error term (exclusion restriction). Trong Stata, lệnh ivregress 2sls y (x = z1 z2), robust thực hiện ước lượng 2SLS (Two-Stage Least Squays): Stage 1 hồi quy X trên Z1, Z2 và các biến ngoại sinh khác để lấy $\hat{X}$, Stage 2 hồi quy y trên $\hat{X}$ và biến ngoại sinh. Để kiểm tra tính hiệu quả của biến công cụ, dùng estat firststage — F-statistic > 10 theo rule-of-thumb của Stock-Yogo cho biết instrument không weak. Lưu ý là 2 điều kiện IV không thể kiểm định đầy đủ từ dữ liệu: relevance có thể test, exclusion restriction phải dựa trên kiến thức lý thuyết kinh tế. Trong nhiều nghiên cứu kinh tế tại Việt Nam, việc tìm biến công cụ thỏa mãn là thách thức lớn — biến thời gian lag, biến địa lý, hoặc biến từ chính sách thường được dùng nhưng cần biện luận kỹ trong bài viết.
Dữ liệu panel (longitudinal data) đòi hỏi phương pháp ước lượng riêng để tận dụng thông tin biến thiên theo thời gian và giữa các đơn vị. Lệnh xtset id time khai báo cấu trúc panel, sau đó xtreg y x, fe thực hiện Fixed Effects (FE) — loại bỏ hiệu ứng không quan sát được giữa các đơn vị ($\alpha_i$) bằng cách demeaning biến theo từng id. Lệnh xtreg y x, re thực hiện Random Effects (RE) — giả định $\alpha_i$ ngẫu nhiên và không correlated với biến giải thích. Để chọn giữa FE và RE, dùng test Hausman: xtreg y x, fe rồi hausman . (dấu chấm refers to last estimation). Nếu p-value < 0.05, bác bỏ RE, chọn FE. Ngoài ra, Stata hỗ trợ phương pháp Dynamic Panel (System GMM) qua lệnh xtabond2 — giải quyết vấn đề endogeneity do biến lagged dependent variable và unobserved heterogeneity. Theo quan điểm của Kho Tàng Kiến Thức VN, việc lựa chọn đúng phương pháp ước lượng panel quan trọng hơn kỹ thuật tính toán — nhiều nghiên cứu sinh áp dụng FE mặc định mà không cân nhắc RE hay Pooled OLS phù hợp hơn với thiết kế nghiên cứu của họ.
Phân tích kết quả và trình bày báo cáo
Sau khi ước lượng, cần diễn giải kết quả theo 3 thành phần: kích thước hiệu ứng (effect size), ý nghĩa thống kê (statistical significance), và ý nghĩa kinh tế (economic significance). Coefficient $\beta_1 = 0.5$ trong hồi quy log_gdp trên education có nghĩa là mỗi năm học thêm tăng log GDP 0.5 đơn vị — để diễn giải dễ hiểu hơn, dùng biến dummy hoặc lấy exponential nếu dependent variable là log. P-value < 0.05 cho biết kết quả có ý nghĩa thống kê ở mức 5%, nhưng cần xem confidence interval: nếu CI [-0.1, 1.1], dù không chứa 0 nhưng khoảng tin cậy quá rộng thì ước lượng không chính xác. Standard error robust (heteroskedasticity-robust, clustered-robust) nên được báo cáo thay vì conventional SE vì giả thiết homoskedasticity hiếm khi đúng trong dữ liệu thực tế.
Cơ chế xuất bảng kết quả đẹp cho báo cáo sử dụng lệnh estout (cần cài đặt từ SSC: ssc install estout). Workflow: sau mỗi ước lượng, dùng est store model1 để lưu kết quả vào memory, lặp cho model2, model3... rồi xuất cùng lúc: esttab model1 model2 model3 using "results.rtf", replace star(* 0.05 ** 0.01 *** 0.001) b(3) se(3). Option b(3) hiển thị coefficient 3 số thập phân, se(3) hiển thị standard error trong ngoặc, star đánh dấu mức ý nghĩa bằng ngôi sao. Kết quả xuất ra RTF có thể copy paste vào Word mà vẫn giữ định dạng bảng. Ngoài ra, outreg2 là package phổ biến khác với cú pháp đơn giản hơn: outreg2 using "results.doc", replace ctitle("Model 1"). Để xuất đồ thị, lệnh twoway vẽ scatter plot + line fit: twoway (scatter y x) (lfit y x) rồi graph export "figure1.png", width(2000) replace xuất ảnh độ phân giải cao cho publication.
Robustness check (kiểm tra độ mạnh của kết quả) là phần bắt buộc trong bài nghiên cứu chất lượng cao. Các phương pháp phổ biến: (1) thay đổi mẫu (loại bỏ outlier, thay đổi khoảng thời gian), (2) thêm biến kiểm soát (control variable) khác, (3) thay đổi phương pháp ước lượng (từ OLS sang IV, FE, RE), (4) thay đổi đo lường biến (thay GDP per capita bằng total GDP, thay log bằng level). Nếu kết quả chính (sign và magnitude của coefficient quan trọng nhất) giữ ổn định qua các specification khác nhau, thì phát hiện có tính robust. Trong Stata, có thể tạo loop để chạy nhiều model tự động: forvalues i = 1/5 { regress y x controli' est store modeli' } rồi xuất bảng so sánh. Việc thực hiện robustness check kỹ lưỡng giúp tăng tính thuyết phục cho bài nghiên cứu và giảm nguy bị reviewer của tạp chí yêu cầu bổ sung phân tích thêm.
Câu hỏi thường gặp
Stata khác gì so với SPSS hay R trong kinh tế lượng?
Stata cân bằng giữa tính thân thiện của SPSS và khả năng lập trình của R. Cú pháp Stata đơn giản hơn R, tập trung vào các lệnh phân tích sẵn có cho kinh tế lượng (IV, GMM, panel) mà không cần viết hàm phức tạp. Tuy nhiên, R mạnh hơn về machine learning và visualization tùy chỉnh, trong khi Stata thuận lợi cho nghiên cứu kinh tế truyền thống với tài liệu hướng dẫn đầy đủ và cộng đồng lớn trong ngành kinh tế.
Phiên bản Stata nào phù hợp cho sinh viên kinh tế?
Sinh viên đại học và thạc sĩ thường dùng Stata/SE đủ cho dataset vài trăm nghìn quan sát. Nghiên cứu sinh và giảng viên làm nghiên cứu lớn có thể cần Stata/MP để xử lý dữ liệu song song. Hầu hết các tính năng kinh tế lượng cơ bản đều có trong Stata/BE (Basic Edition) với giá rẻ hơn — nên xem xét nhu cầu thực tế trước khi mua license.
Làm sao để tự học Stata hiệu quả?
Bắt đầu với tài liệu "Getting Started with Stata" trên website chính thức, học cú pháp cơ bản qua lệnh help [command_name]. Thực hành với dataset mẫu như auto.dta (built-in), từ đó chuyển sang data thực tế. Động lực tốt nhất là áp dụng vào bài tập/nghiên cứu cụ thể — học lệnh theo nhu cầu (ví dụ: cần làm hồi quy thì tìm help regress) sẽ nhớ lâu hơn học trọn bộ tài liệu rồi không dùng.
Stata có hỗ trợ tiếng Việt không?
Giao diện Stata chưa có tiếng Việt, nhưng có thể gõ tiếng Việt trong tên biến, label, và comment bằng lệnh * (single line) hoặc /* */ (multi-line). Kết quả output hiển thị theo tiếng Anh. Tuy nhiên, có thể cài Unicode support để hiển thị tiếng Việt trong đồ thị và bảng bằng lệnh set unicode on (tùy phiên bản).
Tôi có cần biết lập trình trước khi học Stata không?
Không cần nền tảng lập trình trước. Cú pháp Stata được thiết kế theo tư duy thống kê hơn là lập trình — lệnh mô tả hành động (regress, summarize, tabulate) tự nhiên và dễ hiểu. Tuy nhiên, khi làm việc với do-file phức tạp (loop, if-else, macro), kiến thức lập trình cơ bản sẽ giúp viết code hiệu quả hơn. Có thể học dần theo nhu cầu thực tế.
Khám phá
Giáo dục kỹ năng mềm và tư duy phản biện trong đào tạo
5 đột phá quan trọng trong giáo dục năm 2025
IELTS Writing Task 2: phân tích ưu nhược điểm kinh tế
Review phần mềm học tiếng Anh giao tiếp: Đâu nên chọn?
Linking Words trong tiếng Anh: 70+ từ nối và cách dùng chuẩn
Thảo luận
0 bình luậnBài viết liên quan
Sinh viên cơ điện tử CTECH thực tập Canon: Học gì từ thực tế
Phân tích chi tiết trải nghiệm thực tập của sinh viên cơ điện tử CTECH tại Canon Việt Nam năm 2026, đánh giá kỹ năng thực chiến và bài học từ môi trường doanh nghiệp.
Tiếng Anh cho kỹ sư: kỹ năng và lộ trình học phù hợp
Khám phá kỹ năng tiếng Anh cho kỹ sư, cách học theo mục tiêu công việc và lộ trình phù hợp để đọc tài liệu, giao tiếp và thăng tiến sự nghiệp.
Cách phân biệt thì hiện tại đơn và hiện tại tiếp diễn dễ hiểu
Học cách phân biệt thì hiện tại đơn và hiện tại tiếp diễn qua dấu hiệu nhận biết, cấu trúc, cách dùng và bài tập có giải thích dễ hiểu.
Tiếng Anh cho kỹ sư: kỹ năng và lộ trình học phù hợp
Khám phá kỹ năng tiếng Anh cho kỹ sư, cách học theo mục tiêu công việc và lộ trình phù hợp để đọc tài liệu, giao tiếp và thăng tiến sự nghiệp.